AI brengt structuur in archieven en overheidsinformatie

Een geïntegreerde archivistische pipeline met lokale taalmodellen voor historische en recent gevormde informatie
Het Westfries Archief (WFA) ontwikkelt AI-tooling voor het analyseren, structureren, ordenen, beschrijven, verrijken en toegankelijk maken van informatie. Dataspecialist Mitchell Hélant Muller ontwikkelde daarvoor een applicatie die tekstuele en visuele analyse verbindt met een kennisgrafiek, lokale taalmodellen en configureerbare verwerkingsstappen. De toepassing omvat zowel historische archieven als recent gevormde digitale overheidsinformatie en digital legacy.
De innovatie zit in een geïntegreerde archivistische verwerkingsomgeving die grote hoeveelheden informatie stapsgewijs analyseert, relaties herkent, structuur reconstrueert en daaruit bruikbare metadata en beschrijvingen opbouwt. Een samenvatting van een los document maakt nog niet duidelijk bij welk dossier het hoort, welke versie het is of binnen welk werkproces het is ontstaan. De WFA-applicatie brengt zulke informatie bij elkaar in een pipeline waarin eerdere resultaten als invoer voor volgende bewerkingen worden gebruikt. De archiefprofessional houdt daarbij de regie.
Daarmee werkt het WFA aan een bredere opgave dan het maken van inventarisbeschrijvingen. Het doel is informatie duurzaam beheersbaar, vindbaar, begrijpelijk en bruikbaar te maken, vóór én na overbrenging naar een archiefbewaarplaats. De landelijke KVAN-pilot Tot op de bodem bood een omgeving om de door Mitchell ontwikkelde applicatie te testen, kennis uit te wisselen en de mogelijkheden zichtbaar te maken.
Van informatieobject naar samenhangende archiefstructuur
Een archiefstructuur laat zich niet betrouwbaar opbouwen met één opdracht aan een taalmodel. Relevante informatie bevindt zich op verschillende niveaus. Een datum kan uit een document komen, terwijl de functie van dat document pas blijkt uit de samenhang met andere stukken. Voor het herkennen van een dossier zijn vaak gegevens nodig over betrokkenen, onderwerpen, handelingen en het proces waarin de informatie is gevormd.
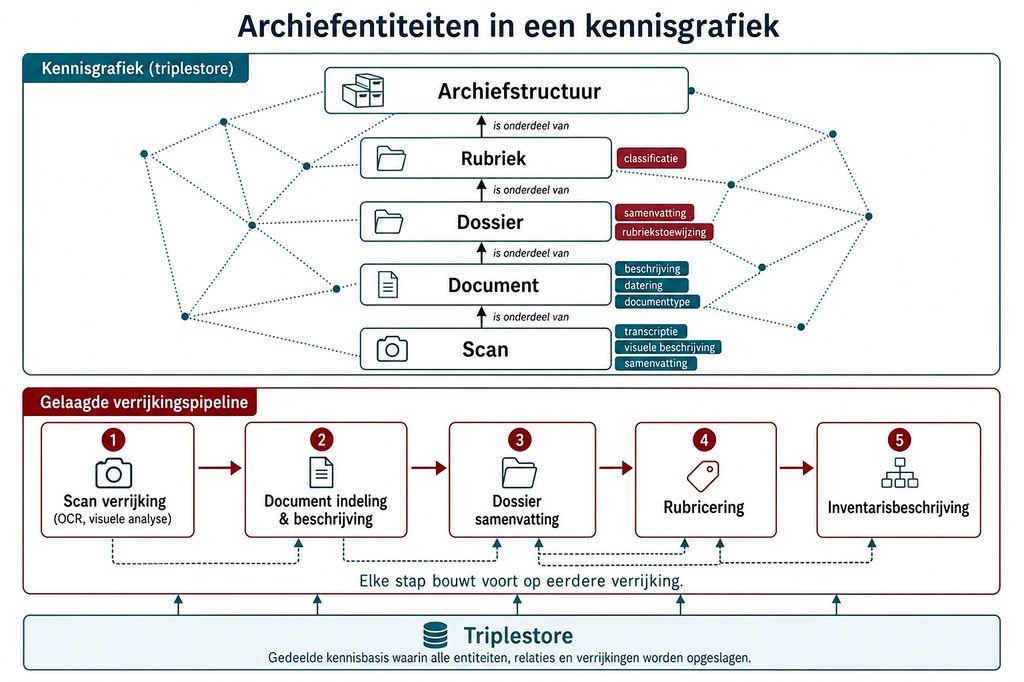
Daarom werkt de applicatie met opeenvolgende verrijkingslagen. Eerst worden kenmerken van informatieobjecten onderzocht, zoals inhoud, vorm, datering en beschikbare metadata. Daarna kunnen documenten worden geclassificeerd, relaties worden gelegd en documentclusters worden gevormd. Die clusters kunnen aanleiding geven tot voorstellen voor dossiers, zaken, processen, rubrieken en een overkoepelende archiefstructuur. De precieze stappen hangen af van het materiaal en de gekozen configuratie.
Voor een historisch archief kan dit betekenen dat losse pagina’s tot documenten worden gegroepeerd en dat documenten vervolgens aan dossiers en rubrieken worden gekoppeld. Bij recent gevormde informatie kan de keten beginnen met bestanden uit een digitale omgeving, inclusief hun bestaande metadata en mappenstructuur. Het vertrekpunt verschilt; de archivistische vraag blijft welke informatie samenhangt en hoe die samenhang verantwoord kan worden vastgelegd.
De verwerking is iteratief. Een eerste analyse levert resultaten op die de professional kan beoordelen en corrigeren. Met een aangepaste prompt, andere invoer of een ander model kan een stap opnieuw worden uitgevoerd. Zo wordt van ongestructureerde informatie naar betekenisvolle structuur toegewerkt, zonder de volledige analyse aan één generatieve opdracht over te laten.
Een kennisgrafiek als fundament
De applicatie gebruikt een triplestore om entiteiten en relaties vast te leggen. Een triple beschrijft een verband tussen een onderwerp, een relatie en een object, bijvoorbeeld: document A is onderdeel van dossier X. Samen vormen zulke uitspraken een kennisgrafiek waarin zowel archiefeenheden als personen, organisaties, plaatsen, onderwerpen en processen met elkaar kunnen worden verbonden.
Aan een document kunnen een datering, documenttype en beschrijving worden gekoppeld. Aan een dossier kunnen vervolgens een samenvatting, betrokken organisatie en relatie met een werkproces worden toegevoegd. Bij een analyse op dossierniveau kan de applicatie voortbouwen op de informatie die eerder op documentniveau is afgeleid. Niet elke verwerkingsstap hoeft daardoor opnieuw bij de bron te beginnen.
De grafiek (ook wel “graaf” voor de liefhebber) biedt meer mogelijkheden dan een uitsluitend hiërarchische mappenstructuur. Een document kan bij een dossier horen, een eerdere versie van een ander document zijn en betrekking hebben op een bepaald pand. Die verbanden kunnen naast elkaar worden vastgelegd. Een traditionele inventaris wordt daarmee één mogelijke weergave van een rijkere kennisstructuur.
Bij het reconstrueren van samenhang is het onderscheid tussen bestaande gegevens en afgeleide interpretaties essentieel. Een aangetroffen dossierkenmerk is iets anders dan een door AI voorgestelde dossierrelatie. Herkomst, oorspronkelijke ordening en de relatie met het bronobject moeten herkenbaar blijven, zodat verrijking geen vervanging van de oorspronkelijke context wordt.
Digital legacy als concrete WFA-toepassing
Het WFA zet de applicatie ook in voor het op orde brengen van recent gevormde digitale overheidsinformatie en digital legacy: digitale informatiebestanden uit bestaande of oudere werkomgevingen waarvan de ordening, metadata of context onvoldoende houvast bieden. Dit is een concrete toepassing binnen het WFA, naast het ontsluiten van historische collecties. De Erfgoedstem beschrijft bijvoorbeeld hoe het WFA de technologie al toepast op ongestructureerde omgevingsvergunningen. De Erfgoedstem – Samen innoveren naar oplossing opgaven archiefsector
Op netwerkschijven, in documentmanagementsystemen en in andere digitale omgevingen kunnen kopieën, concepten en definitieve documenten naast elkaar bestaan. Bestandsnamen zijn niet altijd eenduidig, metadata kan ontbreken en een mappenstructuur vertelt niet vanzelf welk werkproces eraan ten grondslag lag. De applicatie helpt die informatievoorraad te analyseren en voorstellen voor ordening en beschrijving voor te bereiden.
Dubbelingen en ontdubbeling. De analyse richt zich op mogelijke dubbele bestanden en inhoudelijke overlap. Een identieke kopie is iets anders dan een document met kleine wijzigingen of eenzelfde stuk in een andere dossiercontext. Signalering ondersteunt ontdubbeling; de informatiebeheerder beoordeelt welke exemplaren nodig blijven en welke context behouden moet worden.
Versies en versiebeheer. Door inhoud, metadata en dateringen in samenhang te onderzoeken, kunnen mogelijke versierelaties zichtbaar worden. Dat ondersteunt het reconstrueren van een versiegeschiedenis en het verbeteren van versiebeheer. De laatste wijzigingsdatum alleen bewijst niet dat een bestand de definitieve of vastgestelde versie is.
Relaties en documentclusters. De applicatie kan inhoudelijke samenhang signaleren en documenten groeperen rond bijvoorbeeld een onderwerp, pand, organisatie of handeling. Zulke clusters vormen aanknopingspunten voor dossierherkenning. Een thematische overeenkomst is daarbij niet automatisch bewijs dat documenten tot hetzelfde dossier behoren.
Dossiers, processen en zaken. Door documenttypen, betrokkenen, dateringen en inhoudelijke verbanden te combineren, kan worden onderzocht welke stukken bij dezelfde zaak of hetzelfde werkproces horen. De professional toetst de voorgestelde samenhang aan de ontstaanscontext en de werkwijze van de archiefvormer.
Metadata, ordening en context. Aanwezige metadata en mappenstructuren worden betrokken bij de analyse. Ontbrekende beschrijvingen en relaties kunnen worden voorgesteld, terwijl betekenisvolle bestaande ordening behouden blijft. Waar ordening wordt gereconstrueerd, moet zichtbaar blijven welke structuur is aangetroffen en welke achteraf is afgeleid.
De inzet bij digital legacy gaat daarmee verder dan het opschonen van bestanden: de applicatie helpt de informatievoorraad inhoudelijk te reconstrueren. Welke bestanden horen bij elkaar, hoe verhouden versies zich tot elkaar en binnen welk proces is de informatie ontstaan? De kennisgrafiek verbindt de uitkomsten van die analyses. Relaties met versies, dossiers, processen en andere informatieobjecten kunnen naast de bestaande mappenstructuur worden vastgelegd. Zo krijgt de informatiebeheerder een rijker beeld van de informatievoorraad en een beter onderbouwd vertrekpunt voor beheermaatregelen.
De applicatie bereidt de analyse voor. Besluiten over ontdubbeling, herordening, bewaring of vernietiging blijven bij de verantwoordelijke professional. Dat is dezelfde werkwijze als bij historische archieven: geautomatiseerde voorstellen combineren met archivistische beoordeling.
Configureerbare prompts en templates
Archieven en informatiebestanden verschillen te sterk voor één vaste verwerkingswijze. Een verzameling omgevingsvergunningen vraagt om andere documenttypen, metadata en instructies dan historische correspondentie, notariële akten of financiële administratie. Daarom is de applicatie ingericht als een configureerbare werkomgeving.
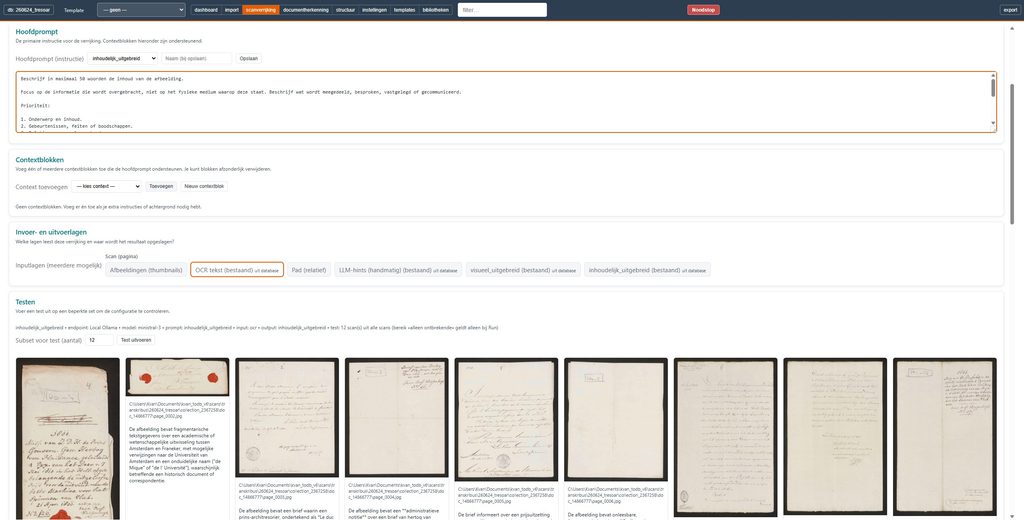
Per stap bepaalt de gebruiker welke informatie als invoer wordt gebruikt, welke opdracht het taalmodel krijgt en waar het resultaat wordt opgeslagen. Prompts kunnen in een bibliotheek worden vastgelegd, getest en hergebruikt. Templates maken het mogelijk een combinatie van instellingen voor vergelijkbaar materiaal opnieuw toe te passen. Zo worden inhoudelijke keuzes onderdeel van een herhaalbare werkwijze.
Een dossierbeschrijving kan bijvoorbeeld worden opgebouwd uit eerder vastgestelde documentbeschrijvingen en dateringen. Voor het herkennen van documenttypen kan juist de oorspronkelijke tekst of een visuele weergave nodig zijn. Door de invoer per stap te kiezen, kan de professional gericht onderzoeken welke informatie nodig is om bruikbare resultaten te krijgen.
Testruns op een beperkte selectie maken vergelijking mogelijk. Wat verandert er wanneer een instructie preciezer wordt, een extra metadataveld wordt meegenomen of een ander model wordt gekozen? Pas na beoordeling van de uitkomsten wordt de verwerking opgeschaald. Iteratief werken betekent daarmee ook dat de configuratie wordt verbeterd voordat fouten zich door een grotere informatieverzameling verspreiden.
Beschikbaar voorandere archiefinstellingen
Het WFA ontwikkelt de applicatie met het uitgangspunt dat de techniek beschikbaar wordt gesteld aan alle archiefinstellingen, zodat zij er binnen hun eigen omgeving zelfstandig mee aan de slag kunnen. De configureerbare opzet maakt het mogelijk de verwerking af te stemmen op eigen informatiebestanden, onderzoeksvragen en werkprocessen.
Het Stadsarchief Amsterdam heeft de door het WFA ontwikkelde techniek inmiddels overgedragen gekregen, met instructies om er zelfstandig mee te experimenteren. Daarmee kan ook buiten het WFA ervaring worden opgedaan met de toepassing en inrichting van de applicatie.
Er bestaat op dit moment nog geen gedeeld platform waarop opslag en beheer voor deelnemende instellingen zijn ingericht. Instellingen die met de techniek aan de slag gaan, moeten daarvoor een eigen technische omgeving en passend beheer organiseren. Het beschikbaar stellen van de applicatie biedt zo een basis voor zelfstandig gebruik en kennisuitwisseling; een gezamenlijke voorziening voor opslag en beheer vraagt om aanvullende inrichting en afspraken.
tekst en beeld in samenhang analyseren
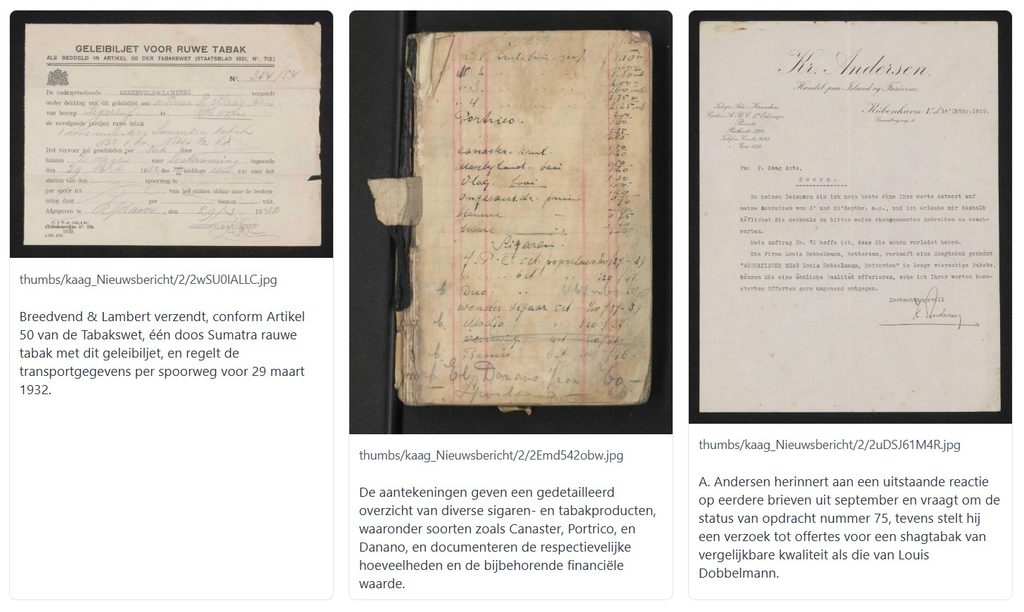
De applicatie combineert taalverwerking met multimodale analyse. Tekst bevat veel inhoudelijke informatie, maar niet alle documentkenmerken laten zich uit tekst alleen afleiden. Briefhoofden, formulieren, stempels, handtekeningen, tabellen, kolomindelingen en aantekeningen kunnen aanwijzingen geven over het documenttype en de functie van een stuk.
Bij historisch materiaal kunnen OCR en HTR, de herkenning van gedrukte en handgeschreven tekst, invoer voor de pipeline leveren. Bij born-digital informatie kunnen beschikbare tekst en metadata het vertrekpunt zijn. Visuele analyse voegt waar nodig informatie toe over vorm en indeling. Digitalisering is daarbij uitsluitend een mogelijke voorbereidende stap voor materiaal dat nog niet digitaal beschikbaar is.
De gecombineerde analyse kan bijdragen aan classificatie, datering, herkenning van namen en organisaties, groepering van documenten en beschrijving van dossiers. Het resultaat krijgt pas archivistische betekenis wanneer het wordt verbonden met andere gegevens en de ontstaanscontext. Een leesbare transcriptie of overtuigende samenvatting is op zichzelf nog geen betrouwbare ordening.
lokale taalmodellen en controle over de verwerking
Het WFA heeft voor de ontwikkeling een eigen AI-werkstation ingericht. Large language models (LLM’s) en de bijbehorende verwerking kunnen binnen de eigen technische omgeving draaien. Bij die lokale inrichting hoeft bronmateriaal voor de modelverwerking niet naar externe commerciële AI-platforms te worden gestuurd. De AI-omgeving draait lokaal binnen een eigen, afgescheiden netwerk van het WFA. Bronmateriaal en AI-verwerking blijven binnen die omgeving; voor de verwerking worden geen externe AI-diensten gebruikt. Deze inrichting geeft het WFA controle over de gegevensverwerking en beperkt de blootstelling aan toegang van buitenaf.
Dat biedt grip op de verwerking van archief- en overheidsinformatie, waaronder materiaal met persoonsgegevens of vertrouwelijke inhoud. Het maakt ook vergelijking van modellen en afstemming op archivistische taken mogelijk. De bruikbaarheid hangt samen met de beschikbare rekenkracht, het gekozen model, de omvang van de invoer en de kwaliteit van de configuratie.
Lokale uitvoering en inhoudelijke betrouwbaarheid zijn afzonderlijke vragen. Ook een lokaal model kan een naam verkeerd lezen, een verband missen of een onjuiste beschrijving genereren. Daarom blijven controleerbare verwerkingsstappen en menselijke beoordeling noodzakelijk.
de archiefprofessional blijft in the lead
Human-in-the-loop is een fundamenteel ontwerpprincipe. De professional bepaalt de configuratie, beoordeelt testruns, controleert voorgestelde relaties en structuren en kan corrigeren voordat resultaten verder door de pipeline worden gebruikt. De applicatie ondersteunt het vakmanschap dat nodig is om informatie te duiden.
Dat is vooral van belang bij opeenvolgende analyses. Als een document in een vroeg stadium verkeerd wordt geclassificeerd, kan dat doorwerken in de samenstelling en beschrijving van een dossier. Controle moet daarom betrekking hebben op zowel afzonderlijke resultaten als de samenhang tussen verwerkingsstappen. Onzekere relaties vragen om toetsing, niet om automatische bevestiging door een volgende modelbewerking.
De werkwijze verschuift een deel van het werk van afzonderlijk lezen en beschrijven naar het beoordelen van patronen, uitzonderingen en context. Hoeveel tijd dat bespaart en welke kwaliteit wordt bereikt, moet per toepassing worden vastgesteld. De gedemonstreerde Proof of Concept is geen algemene kwaliteitsgarantie voor ieder brontype of elke configuratie.
Duurzaam informatiebeheer en het recht op informatie
Goede toegankelijkheid begint vóór overbrenging. Dezelfde onderliggende architectuur ondersteunt zowel informatiebeheer vóór overbrenging als archiefbeheer erna. Daarmee wordt de technische scheidslijn tussen beide minder bepalend: de analyse van documenten, relaties, metadata en context is bruikbaar in de gehele informatieketen, van actuele en semi-statische overheidsinformatie tot historisch archief. Een inwoner die informatie zoekt over een vergunning of besluit heeft er direct belang bij dat relevante stukken vindbaar zijn, versies van elkaar kunnen worden onderscheiden en duidelijk is binnen welke zaak of welk proces documenten zijn ontstaan. Die samenhang blijft ook na overbrenging van belang voor onderzoek, verantwoording en hergebruik.
Metadata-extractie, relatieherkenning, versieanalyse en reconstructie van ordening dragen daarom bij aan duurzaam informatiebeheer. Ze helpen informatie begrijpelijk en beheersbaar te houden wanneer systemen veranderen, medewerkers vertrekken of oorspronkelijke werkverbanden minder zichtbaar worden. Het behouden van bronobjecten en herkomstgegevens is daarbij net zo belangrijk als het toevoegen van nieuwe beschrijvingen.
De koppeling met het recht op informatie is concreet: informatie kan pas daadwerkelijk worden gevonden en begrepen wanneer niet alleen het afzonderlijke document, maar ook de relevante context toegankelijk is. De applicatie kan de informatievoorziening ondersteunen; de beoordeling welke informatie openbaar kan worden gemaakt blijft onderdeel van het verantwoordelijke beheerproces.
Dezelfde kennisstructuur kan bovendien verschillende toegangen ondersteunen. Een onderzoeker zoekt een gedetailleerde archiefbeschrijving, een inwoner informatie over een pand en een ambtenaar stukken uit een besluitvormingsproces. In potentie kunnen zulke toegangen op dezelfde onderliggende gegevens en relaties worden gebaseerd. Daarbij moet steeds naar de bron kunnen worden teruggekeerd.
Tot op de bodem als landelijke testomgeving
De landelijke KVAN-pilot Tot op de bodem was oorspronkelijk gericht op een herhaalbare methodiek voor geautomatiseerde archiefontsluiting, niet op de ontwikkeling van deze applicatie. Het project bood een test-, leer- en samenwerkingsomgeving en gaf de WFA-applicatie landelijke zichtbaarheid. Deelnemende instellingen brachten materiaal en praktijkkennis in en in een kleinere setting werd de applicatie met vakgenoten beproefd. De gepresenteerde applicatie is ontwikkeld door Mitchell Hélant Muller van het WFA. De bijdrage van de landelijke pilot betreft voornamelijk het testen, leren, samenwerken rond het materiaal en zichtbaar maken van die ontwikkeling.
Ook Het Utrechts Archief was bij de start van Tot op de bodem betrokken en legde vanuit de eigen expertise een waardevolle basis voor technieken die het beschrijven van bestaande archiefcollecties ondersteunen. De Utrechtse inzet richtte zich destijds op die collectiegerichte toepassing. Het WFA bouwt met zijn applicatie daarnaast aan het analyseren en structureren van recent gevormde digitale overheidsinformatie, de zogenoemde digital legacy.
KVAN noemt op de themapagina bij de laatste testdag in augustus 2026 de applicatie van Mitchell bij het WFA KVAN – Pilot Tot op de bodem. Op 14 september 2026 demonstreerde Mitchell de toepassing tijdens de presentatie van de resultaten van deze eerste pilotfase in bijzijn van ruim 40 collega archiefinstellingen, het Nationaal Archief en het ministerie van OCW.
Doorontwikkeling vanuit de WFA praktijk
De landelijke pilot heeft een waardevolle bijdrage geleverd aan het beproeven van de applicatie, het uitwisselen van kennis en het zichtbaar maken van de mogelijkheden voor de archiefsector. Het WFA hecht aan die uitwisseling en aan de rol van KVAN als brancheorganisatie die instellingen en expertise met elkaar verbindt.
Voor het WFA ligt het zwaartepunt van de verdere technische ontwikkeling bij de toepassing in de eigen praktijk. Vanuit de overheidspartners ligt inmiddels een aanzienlijke hoeveelheid opdrachten om de technologie in te zetten voor het analyseren, structureren en toegankelijk maken van informatie. Die concrete vraag vormt de basis voor de ontwikkelagenda en het tempo waarin het WFA de applicatie verder brengt.
Het WFA bouwt daarom vanuit de eigen expertise en infrastructuur voort op de bestaande applicatie. De aandacht gaat daarbij uit naar historische archieven én complexe recent gevormde digitale informatie: de zogenoemde digital legacy. Ervaringen uit deze opdrachten worden benut om de verwerkingsstappen te verfijnen, de kwaliteit te toetsen en de inzetbaarheid te vergroten.
Deze praktijkgerichte doorontwikkeling biedt ook nieuwe aanknopingspunten voor kennisdeling en samenwerking binnen de sector. Waar vraagstukken, expertise en ontwikkeltempo op elkaar aansluiten, kunnen verbindingen ontstaan die zowel de WFA-praktijk als het bredere archiefveld verder helpen. Voor het WFA blijft de concrete informatieopgave van de overheidspartners daarbij richtinggevend: informatie duurzaam beheersbaar maken en burgers, onderzoekers en overheidsorganisaties beter in staat stellen die te vinden, te begrijpen en te gebruiken.